Команда из 20 человек на ChatGPT Business — это $400 в месяц при годовой оплате, и каждый новый сотрудник добавляет к счету еще $20.
Общий сервер с Open WebUI и API с оплатой за токены обойдется той же команде примерно в $139 в месяц (при допущениях по нагрузке, которые описаны ниже).
А GPU-сервер с локальными моделями стоит фиксированную сумму, сколько бы людей ни было в штате.
Ниже сравниваем варианты, а потом пошагово настраиваем ИИ для команды с таймингами из нашей собственной установки.
Почему личные ИИ-подписки не масштабируются на команду
Подписки за место дорожают с каждым наймом, держат промпты каждого сотрудника в его личном аккаунте и отправляют данные компании на серверы вендора. На 20–30 людях это уже ощутимо. Microsoft в Work Trend Index 2024 выяснила, что 78% пользователей ИИ приносят на работу собственные ИИ-инструменты, а в малом и среднем бизнесе — 80%. Если команда уже платит за несколько ИИ-подписок, объедините их до следующего найма.
Общий ИИ-сервер — это один инстанс, к которому подключается вся команда: один счет, одно место хранения данных, одна база для общих наработок. Так компания получает приватный ИИ без тарифов за место — по сути, свой корпоративный ChatGPT.
Расходы растут с каждым наймом
ChatGPT Business стоит $20 за пользователя в месяц при годовой оплате или $25 при помесячной, минимум — два места. При такой модели 30 человек обходятся в $600–750 в месяц, а новый сотрудник — это еще одно место, неважно, пользуется он ИИ каждый день или дважды в квартал.
Нет общего контекста
Каждый пишет промпты с нуля в своем аккаунте. Помощник юриста довел до ума промпт для проверки договорных формулировок, и тот так и остался в его истории. Остальным от этого ни тепло ни холодно.
Нет контроля над данными
Личные подписки — это еще и личное решение каждого, что и куда вставлять. Отчет Thomson Reuters Future of Professionals 2026 показал, что 34% специалистов пользуются ИИ-инструментами, которые их организация не одобряла. Собственный ИИ-ассистент компании дает всем одобренное место для работы.
Общий ИИ-сервер vs ChatGPT Business: реальная стоимость для 10–30 человек
Для команды из 10–30 человек общий сервер с внешним API стоит 33–40% от годовой цены ChatGPT Business (при наших допущениях по нагрузке).
GPU-сервер с локальными моделями окупается только примерно от 35 мест — это на сервере с Tesla T4, который мы тестировали.
Все цены ниже взяты со страниц тарифов самих вендоров и проверены в октябре 2026 года. Если вы сейчас платите больше, чем за 10 мест, прогоните свои цифры через таблицу.
|
Вариант |
10 человек |
20 человек |
30 человек |
Точка окупаемости |
|
ChatGPT Business (годовая / помесячная оплата) |
$200 / $250 |
$400 / $500 |
$600 / $750 |
Точка отсчета |
|
Microsoft 365 Copilot Business, надстройка (прайс / промо) |
$210 / $180 |
$420 / $360 |
$630 / $540 |
Нужен тариф Microsoft 365 Business сверху |
|
GPU-сервер NL4-8 с Tesla T4 16 GB, Ollama + Open WebUI |
$693,75 |
$693,75 |
$693,75 |
Около 35 мест ChatGPT Business |
|
GPU-сервер NL3-22 с NVIDIA L4 24 GB (только предзаказ) |
$409,17 |
$409,17 |
$409,17 |
Около 21 места ChatGPT Business |
|
Open WebUI на VPS Medium + внешний API |
$80,04 |
$138,84 |
$197,64 |
Дешевле уже с 2 пользователей при этих допущениях |
Как считали строки (цены is*hosting — помесячные при годовой оплате, зависят от локации):
- ChatGPT Business: $20 за пользователя в месяц при годовой оплате, $25 при помесячной (данные OpenAI). ChatGPT для команд, бывший тариф ChatGPT Team, теперь продается как ChatGPT Business.
- Copilot Business: $21 за пользователя в месяц по годовой подписке, промоцена — $18 до 31 декабря 2026 года на первый год подписки. Продается только действующим клиентам с подходящим тарифом Microsoft 365 Business; Business Standard стоит $14 за пользователя в месяц.
- GPU-серверы: цены из конфигуратора GPU-серверов is*hosting на 28 октября 2026 года, локация — Нидерланды. NL4-8 (AMD EPYC 7702P, 256 GB RAM) с Tesla T4 16 GB стоит $693,75 в месяц при годовой оплате ($8 325 в год). NL3-22 (AMD Ryzen 7 7600X, 64 GB RAM) с NVIDIA L4 24 GB — $409,17 в месяц при годовой оплате ($4 910 в год), на тот момент был доступен только по предзаказу. Цены «от» на странице GPU-серверов указаны с картой начального уровня — T4 или L4 ставятся вместо нее.
- Вариант с API: VPS Medium от is*hosting (3 CPU, 4 GB RAM) за $21,24 в месяц при годовой оплате плюс API по тарифам GPT-6.1 Sol: $2 за миллион входных токенов и $10 за миллион выходных. Мы исходили из 40 запросов на человека за рабочий день, 21 рабочий день, 1 500 входных и 400 выходных токенов на запрос. Получается $5,88 на человека в месяц. У Claude Sonnet 5.5 прайс такой же — $2/$10.
Более широкое сравнение селф-хостинга с софтом за место в нашем обзоре ИИ-инструментов для бизнес-аналитики.
В таблицу не попали три вещи, которые общий сервер умеет, а подписки нет:
- Дешевые и дорогие модели в одном окне. Open WebUI отдает локальные модели Ollama и API-модели бок о бок. Рутинные переформулировки уходят в модель за $0,10 за миллион входных токенов, и только сложные вопросы — в модель за $2.
- Редкие пользователи ничего не стоят. Юзеру, которому ИИ нужен пару раз в месяц, заводят аккаунт в админке — без места за $20. Удаляется он на том же экране.
- Доступ только после одобрения. Если открыть регистрацию, новые аккаунты получают роль pending, пока их не одобрит админ. Случайный человек, наткнувшийся на страницу входа, ничего не увидит.
Что общий ИИ-сервер дает команде, чего не дают подписки
Для команд, которые раз за разом решают одни и те же задачи — юридические проверки, ответы саппорта, черновики коммерческих предложений, — общий сервер превращает разрозненное использование ИИ в полноценную ИИ-инфраструктуру для малого бизнеса. Библиотека промптов для всех, правила работы с данными, которые админ задает один раз, и возможность сменить модель без переноса аккаунтов.
Опрос Thomson Reuters Future of Professionals 2025 показал: специалисты ожидают, что в ближайший год ИИ будет экономить им около 5 часов в неделю. Если у кого-то в команде уже есть промпт, который экономит время, сервер — это способ раздать его остальным.
Общая библиотека промптов
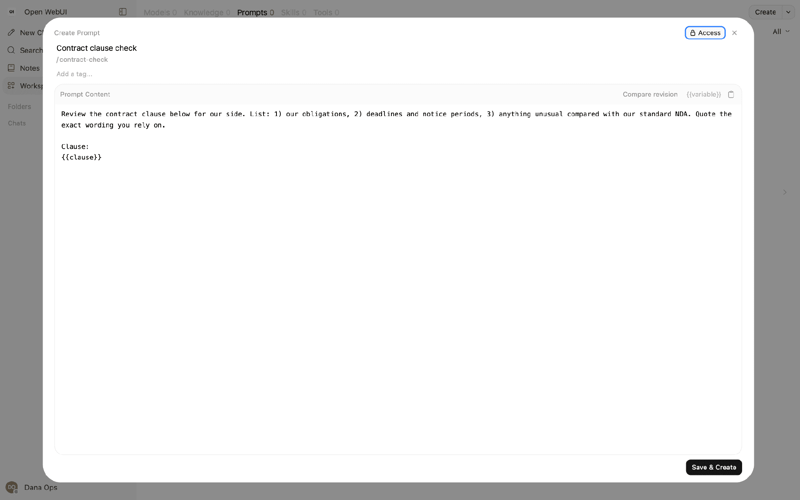
В Open WebUI админ один раз пишет промпт, назначает ему слеш-команду, например /contract-check, и открывает доступ группе. Все в этой группе видят его, как только наберут /.
Централизованный контроль данных
Группы определяют, кто видит какую модель, промпт и базу знаний. В нашем тесте пользователь из Legal открывал базу знаний «Legal templates», а пользователь из Sales на том же сервере не видел ни баз знаний, ни промптов. Вот что такое приватный ИИ для бизнеса на практике: куда идут данные, решает админ.
Без привязки к вендору
Чаты, пользователи и документы лежат в Docker-томе на вашем сервере. Переход с одной модели на другую или с локальной на API — это смена настроек, аккаунты остаются на месте.
Представьте юрфирму на 12 человек, где помощник юриста прогоняет каждое входящее NDA через общий промпт /contract-check, завязанный на шаблон фирмы. Если это сэкономит хотя бы половину тех 5 часов в неделю, на которые рассчитывают специалисты из опроса Thomson Reuters, фирма получит обратно около 10 часов работы помощника в месяц. И промпт продолжит работать, даже когда помощник в отпуске.
Выделенный сервер
Разверните приватный ИИ-сервер для всей команды на выделенном железе, в том числе в конфигурациях с GPU для локальных моделей.
Как настроить общий ИИ-сервер: пошаговая инструкция
Вся настройка ИИ-сервера для офиса заняла у нас около 20 минут на Ubuntu 24.04: примерно 6 минут на команды (большая часть — скачивание образов), остальное — в админке. Базовая установка подробно разобрана в нашем гайде по Open WebUI; ниже коротко о ней и подробно о настройке под команду. Протестированные версии: Open WebUI 0.12.3, Ollama 0.40.6, Docker 29.9.1, Docker Compose 5.6.0.
|
Шаг |
Что делаем |
Время в нашем прогоне |
|
1 |
Установить Docker |
16 с |
|
2 |
Запустить Open WebUI и Ollama |
3 мин 20 с (холодная загрузка образов и первый запуск) |
|
3 |
HTTPS через Nginx и Certbot |
Около 1 мин |
|
4 |
Создать аккаунт админа |
Около 1 мин |
|
5 |
Добавить пользователей и группы |
Около 5 мин на две группы |
|
6 |
Скачать модель и открыть к ней доступ |
38 с для qwen3.5:4b (3,3–4,0 GB), около 80 с для gemma4:12b (7,7–8,0 GB) плюс 1 мин кликов |
|
7 |
Создать общие промпты |
Около 2 мин на промпт |
|
8 |
Собрать базу знаний |
Около 3 мин |
1. Установите Docker
На серверах is*hosting Docker не предустановлен. Зайдите под root и выполните:
curl -fsSL https://get.docker.com | sh2. Запустите Open WebUI и Ollama
mkdir -p /root/open-webui && cd /root/open-webui
printf 'WEBUI_SECRET_KEY=' > .env && openssl rand -hex 32 >> .env
cat > compose.yaml << 'EOF'
services:
  ollama:
    image: ollama/ollama:0.40.6
    container_name: ollama
    environment:
      - OLLAMA_NUM_PARALLEL=4
      - OLLAMA_CONTEXT_LENGTH=8192
      - OLLAMA_KEEP_ALIVE=30m
    volumes:
      - ollama:/root/.ollama
    restart: unless-stopped
  open-webui:
    image: ghcr.io/open-webui/open-webui:v0.12.3
    container_name: open-webui
    depends_on:
      - ollama
    ports:
      - "127.0.0.1:3000:8080"
    env_file:
      - .env
    environment:
      - OLLAMA_BASE_URL=http://ollama:11434
      - WEBUI_URL=https://YOUR_DOMAIN
      - CORS_ALLOW_ORIGIN=https://YOUR_DOMAIN
    volumes:
      - open-webui:/app/backend/data
    restart: unless-stopped
volumes:
  ollama:
  open-webui:
EOF
docker compose pull -q && docker compose up -d
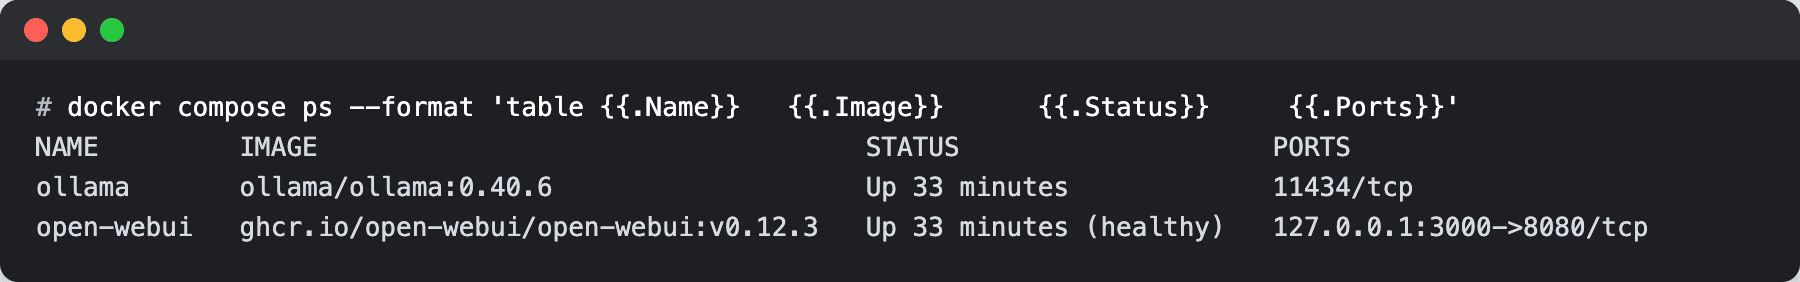
Два образа заняли на диске 15,75 GB еще до любой модели, docker system df показывает ту же сумму. Около 5,4 GB из них — сжатая загрузка: начиная с Docker Engine 29, новые установки используют хранилище образов containerd, которое держит и сжатые слои, и распакованные (документация Docker). Open WebUI перешел в статус «healthy» в docker compose ps примерно через три минуты после начала загрузки. Модель эмбеддингов для поиска по документам (all-MiniLM-L6-v2) встроена прямо в образ: в нашем тесте Open WebUI запустился и загрузил ее даже с отключенной сетью.
На GPU-сервере сначала установите драйвер NVIDIA и NVIDIA Container Toolkit, затем добавьте gpus: all в сервис ollama, как описано в документации Ollama по Docker.
3. Настройте HTTPS
Порты, опубликованные через Docker, обходят правила ufw: в нашем тесте порт 3000 отвечал из интернета при включенном ufw, хотя разрешающего правила для него не было. Поэтому в compose-файле Open WebUI привязан к 127.0.0.1. Поставьте перед ним Nginx с заголовками для WebSocket и получите сертификат:
apt-get update && apt-get install -y nginx certbot python3-certbot-nginx
cat > /etc/nginx/sites-available/open-webui << 'EOF'
server {
    listen 80;
    server_name YOUR_DOMAIN;
    location / {
        proxy_pass http://127.0.0.1:3000;
        proxy_http_version 1.1;
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection "upgrade";
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
        proxy_buffering off;
        proxy_read_timeout 600s;
        client_max_body_size 100m;
    }
}
EOF
ln -s /etc/nginx/sites-available/open-webui /etc/nginx/sites-enabled/
nginx -t && systemctl reload nginx
certbot --nginx -d YOUR_DOMAIN --redirect
ufw allow OpenSSH && ufw allow 'Nginx Full' && ufw --force enable
4. Создайте аккаунт админа
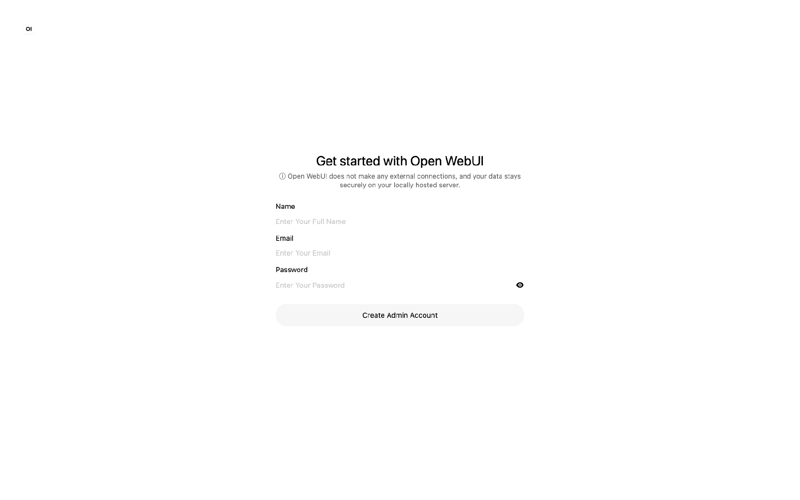
Откройте https://YOUR_DOMAIN, нажмите Get started и заполните форму Create Admin Account. Первый аккаунт становится администратором, и после его создания Open WebUI сам отключает New Sign Ups.
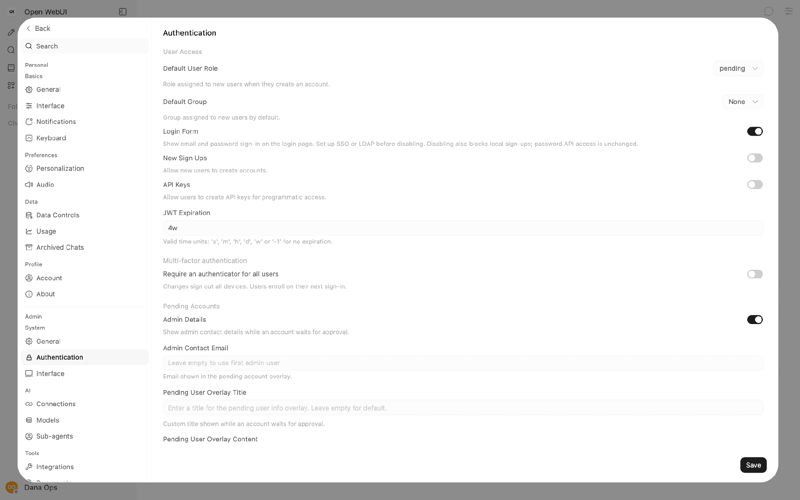
Проверьте настройки по умолчанию: ваше имя (внизу слева) > Settings > Admin > Authentication. Default User Role — pending, Default Group — None, плюс есть переключатель, который требует приложение-аутентификатор от всех пользователей. После любого изменения жмите Save: в нашем тесте без этого переключатель после перезагрузки страницы возвращался в исходное положение.
5. Добавьте пользователей и группы
Откройте Admin Panel > Users > Overview > Add User, чтобы добавлять людей по одному, или вкладку CSV Import — чтобы завести весь офис сразу. Затем перейдите на вкладку Groups, нажмите New Group и создайте по группе на каждую функцию, например Legal и Sales.
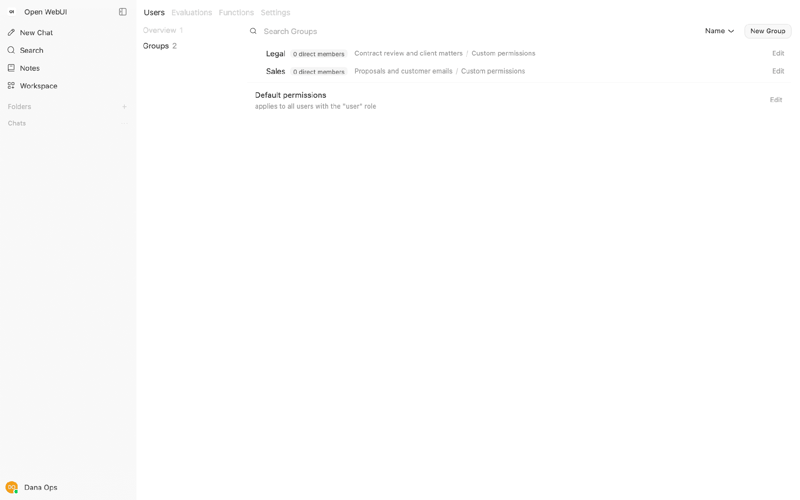
Участников назначайте на вкладке Users внутри каждой группы — чекбоксы сохраняются сразу. Права групп только добавляют доступ, поэтому пользователь из двух групп получает права обеих.
6. Скачайте модель и откройте к ней доступ
docker exec ollama ollama pull gemma4:12bНовые модели появляются со статусом Private — их видят только админы. В нашем тесте обычный пользователь залогинился и увидел «Select a model» с пустым списком.
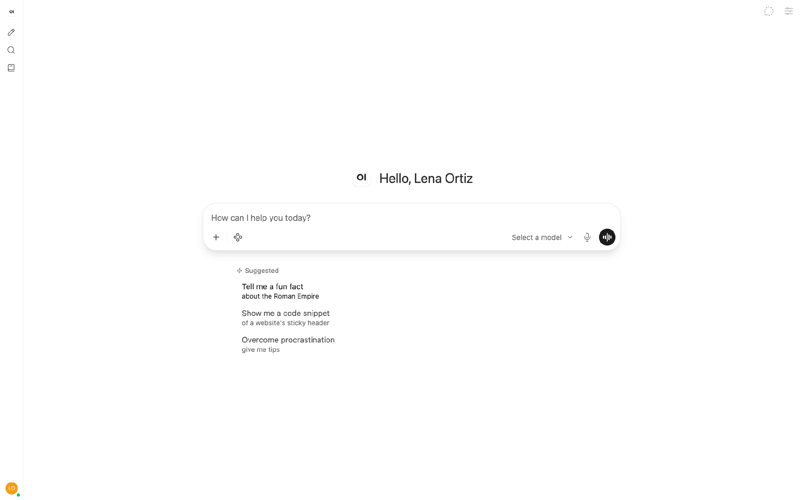
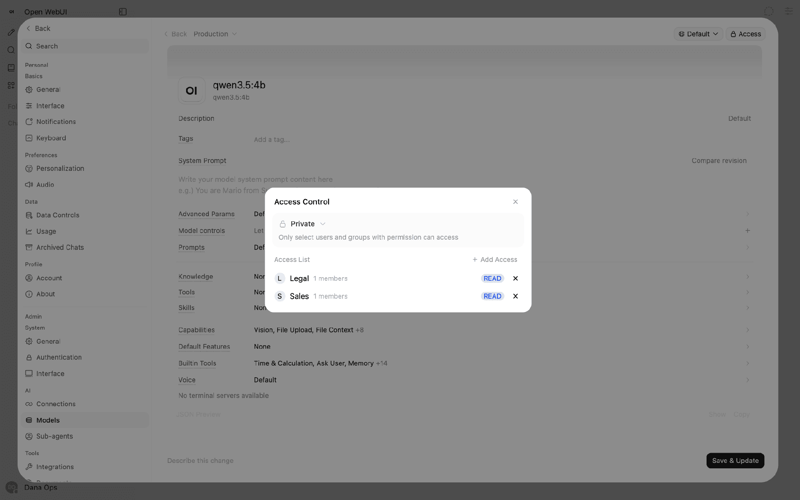
Чинится это в Settings > Admin > Models: нажмите на карандаш рядом с моделью, затем Access > Add Access, отметьте группы, нажмите Add и завершите кнопкой Save & Update. Метка модели сменится с Private на Shared. Чтобы отдать модель сразу всем пользователям, переключите меню Access с Private на Public — метка станет Public.
7. Создайте общие промпты
Перейдите в Workspace > Prompts > Create. Заполните название, команду (например, contract-check) и текст промпта; {{clause}} обозначает переменную, которую подставляет пользователь. Через Access откройте доступ группе и нажмите Save & Create.
8. Соберите базу знаний
Перейдите в Workspace > Knowledge > Create, дайте базе имя, через Add Access выберите группу, нажмите Create Knowledge и загрузите файлы. Пользователи подключают базу к чату, набрав #.
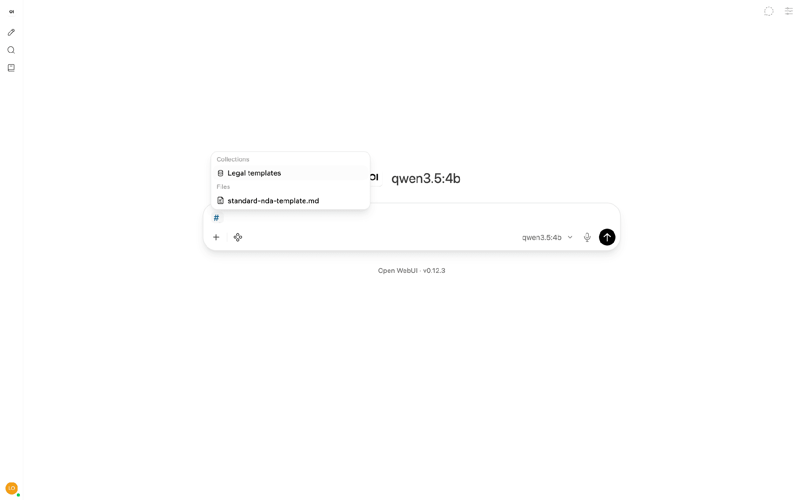
У пользователя из Sales то же меню # пустое — база знаний принадлежит Legal.
По умолчанию обычные пользователи вообще не видят Workspace. Чтобы руководители направлений могли сами собирать промпты и базы знаний, включите в их группе соответствующие права Workspace.
Какая конфигурация сервера нужна вашей команде?
Сервера без GPU хватит для тестов на одного-трех человек. Команде нужен GPU-сервер или связка Open WebUI + API, а размер выбирают по тому, сколько людей отправляют запрос одновременно.
В наших тестах 4B-модель на 8 ядрах CPU отвечала 32 секунды и обрабатывала по одному запросу за раз, а Tesla T4 закончила восемь одновременных ответов за 11 секунд. Если одновременно будут работать больше трех человек, вариант без GPU даже не рассматривайте.
|
Размер команды |
RAM / vCPU сервера |
GPU |
Модель |
Замеренное время ответа (200 токенов) |
|
1–3, тесты |
32 GB / 8 vCPU (Exclusive VPS) |
Нет |
qwen3.5:4b |
32 с на ответ; запросы встают в очередь, 4-й из 4 завершился на 129-й секунде |
|
5–10 |
GPU-сервер |
Tesla T4 16 GB |
gemma4:12b, 4 параллельных слота |
4 одновременных ответа за 7 с |
|
10–30 |
GPU-сервер |
Tesla T4 16 GB |
gemma4:12b, 8 слотов, контекст 8K |
8 одновременных ответов за 11 с, занято 14,5 из 15,4 GB VRAM |
|
30–50 |
GPU-сервер или несколько GPU |
NVIDIA L4 24 GB или multi-GPU по запросу |
gemma4:12b или крупнее |
Не замеряли; на T4 при 8 слотах VRAM уже не оставалось |
|
Любой, вариант с API |
4 GB / 3 vCPU (VPS Medium) |
Нет |
Внешний API |
Зависит от API-провайдера; сам Open WebUI занимал около 1 GB RAM |
Строки с GPU замерены на Tesla T4 16 GB — эта карта стоит в сервере NL4-8 от is*hosting за $693,75 в месяц при годовой оплате. NL3-22 с NVIDIA L4 24 GB дешевле ($409,17 в месяц при годовой оплате) и дает на 8 GB больше VRAM, а L4 мы не тестировали.
Строка «10–30» исходит из того, что одновременно запросы отправляет только часть команды: при 8 одновременных запросах у T4 не оставалось памяти на длинный контекст. Во все тарифы is*hosting входят выделенный IPv4-адрес и еженедельные бэкапы.
Когда общий сервер не нужен
ИИ-сервер для малого бизнеса — неудачный выбор в нескольких типичных ситуациях:
- Команда меньше примерно 35 человек, и хочется локальных моделей. В этом случае ChatGPT Business с годовой оплатой дешевле сервера с Tesla T4 (для сервера с L4 по предзаказу порог — около 21 человека).
- Вам нужны самые свежие frontier-модели. Прежде чем отказываться от платных мест, проверьте, справляются ли открытые модели, которые помещаются в карту на 16–24 GB, с вашими самыми сложными задачами. Вариант с API закрывает этот разрыв, но тогда промпты уходят провайдеру.
- За обслуживание никто не отвечает. Кто-то должен ставить обновления, следить за местом на диске и проверять бэкапы.
- Медицинские или юридические данные с договорными требованиями. Прежде чем загружать регулируемые данные, уточните свои обязательства, в том числе что должно быть закреплено в договоре с хостинг-провайдером.
Если ничего из этого не про вас, выбор сводится к двум вариантам: GPU-сервер для локальных моделей или VPS Medium плюс API-ключ, если запускать модели самостоятельно не хочется.
В заключение
ИИ для команды — это не обязательно отдельное место на каждого. Один сервер с Open WebUI дает команде приватный ИИ: общие промпты, доступ на уровне групп и закрытую базу знаний — и все это настраивается примерно за 20 минут.
Для локальных моделей начните с GPU-сервера is*hosting; самый бюджетный вариант — тариф Medium на странице VPS плюс API-ключ. А если нужен ассистент, который действует сам, загляните в наш гайд по Clawdbot с Docker и Ollama.